软件工程师LLM Infra入门——Transformer
深入浅出LLM Infra,这一篇就够了
目录
NOTE
最近在学习Infra相关的内容,这篇blog主要是对学习过程中知识的总结和巩固,并不是介绍或者指导怎么学习
理解Transformer基本就理解了目前主流LLM的核心。主流的LLM可以被视为是Transformer架构的变体,一个LLM是多个Decoder Block的堆叠。因此大部分训推框架的优化都从堆叠,以及block内部的结构出发的。
Transformer
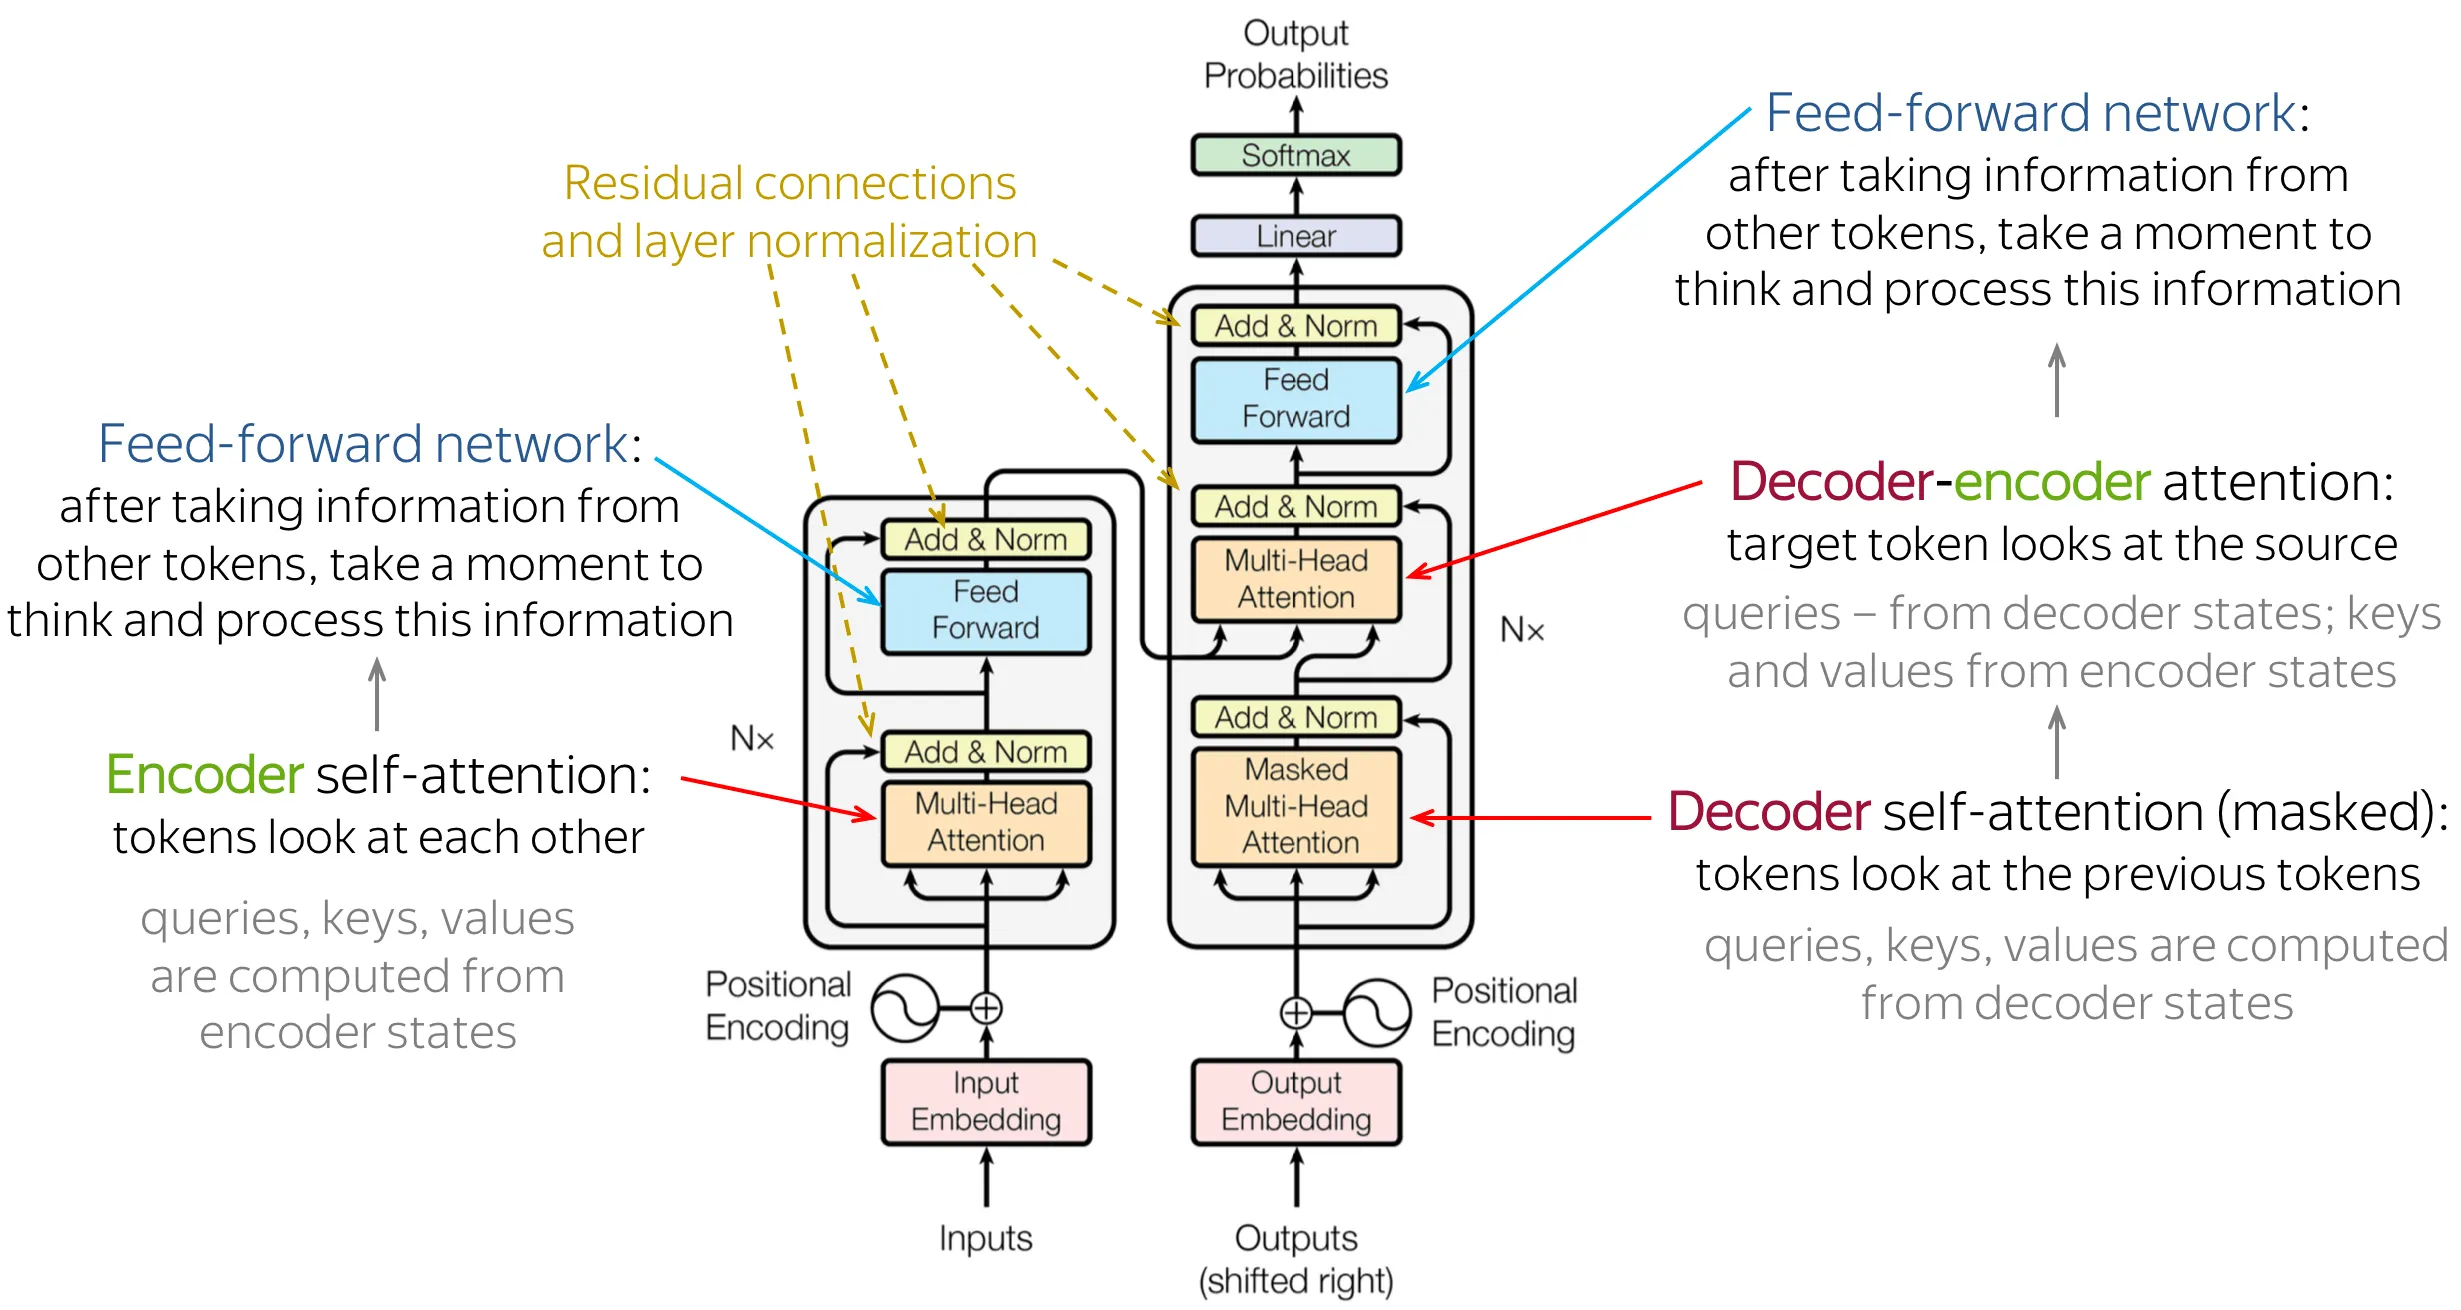
最开始的Transformer架构有encoder和decoder两种,就像名字,encoder输入文本输出表征,decoder输入表征输出token。现在的LLM里已经没有encoder只有decoder了,结构也变成了decoder的堆叠。目前,文本会先被tokenizer切分成token,再由embedding层变成矩阵,行是token数,列是token维度,最后由LM head(也叫unembedding,很多模型会和embedding层共享权重)算出下一个token的概率分布,选出token后再由tokenizer解码成具体的文本。
相比于RNN和LSTM,Transformer架构的优势主要有三点:
并行。RNN的计算是,第t步必须等第t-1步算完,长度为N的序列就是N次串行的小矩阵乘法,GPU根本吃不满。而Transformer在训练时所有位置可以一次算完,整个序列就是几个大的矩阵乘法(GEMM),正好可以吃满GPU的Tensor Core。
长距离相关性。RNN里位置i的信息要传到位置j,需要经过j-i次状态更新,信息被不断压缩进一个固定大小的hidden state,梯度也要沿着这条链回传,很容易消失或者爆炸(LSTM的门控只是缓解了这个问题)。而self-attention中任意两个位置之间都直接计算一次相似度,路径长度是,而且这个权重是根据输入动态算出来的。
训练高效,但推理有代价。训练时通过因果掩码(causal mask),一次前向就能得到所有N个位置的loss;推理时prefill阶段同样可以并行,只有decode阶段还是逐token自回归。代价是RNN每一步只需要维护一个固定大小的状态,而Transformer需要保存所有历史token的KV Cache,显存随序列长度线性增长,attention的计算量随序列长度平方增长。后面的KV Cache管理、GQA/MLA、FlashAttention等优化基本都是在解决这个问题,Mamba、RWKV等线性架构也是希望把RNN推理的优势找回来。
Decoder Block
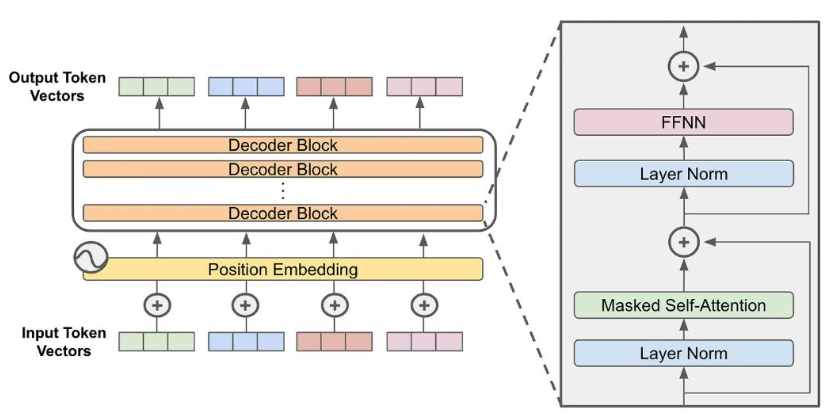
LLM = Decoder block的堆叠,因此理解先理解decoder里都有什么内容,其实右图写的非常明白了,有Norm层,Attention层,FFN层,然后还有残差连接和位置编码,每一部分具体内容和作用先不展开。Decoder Block输入和输出大小一致,因此可以无限堆叠,而且也方便我们做训推的拆分。这里去掉了输入和输出相关的部分。
一个decoder block会涉及到多少参数呢?假设一个token特征的维度是,那么attention有4个的矩阵,然后FFN里涉及到升维降维和gate矩阵,大约是的参数(如果没有gate矩阵也是),这里就有的参数量了。因此,增加维度带来的参数量变化比增加层数带来的更多。
IMPORTANT
这个二次方关系直接影响显存规划和并行策略。宽度翻倍意味着每层参数量翻四倍,单张卡可能放不下一层——这时需要张量并行(Tensor Parallelism)在层内切分。层数翻倍则可以用流水线并行(Pipeline Parallelism)在层间切分。实际部署中往往需要两者结合。
Decoder block的堆叠也带来了架构统一性。整个模型只有一种 Block 结构反复堆叠,这意味着:
- CUDA kernel 只需要优化一套(同样的 Attention kernel、同样的 FFN kernel 复用 L 次)
- 并行策略只需要设计一次(不需要 Encoder/Decoder 分别调度)
- 性能分析和瓶颈定位更简单(任意一层的特性代表所有层)
KV Cache 管理简单。只有一套 KV Cache 需要管理,PagedAttention 等优化技术可以直接应用,不需要处理 Encoder 输出的缓存和 Decoder KV Cache 的两套数据。
Scaling 路径清晰。想要更大的模型?增加层数、增加宽度、增加头数——三个旋钮,效果可预测。不需要纠结 Encoder 和 Decoder 的比例分配。
训练数据利用率高。“预测下一个 token” 的训练目标意味着每个 token 都产生一个训练信号(loss),数据利用率接近 100%。而 Encoder-Decoder 的训练信号只在 Decoder 部分产生,Encoder 的梯度全靠 Decoder 的 loss 回传。
Self-Attention
Attention is all you need! Attention机制的理解其实也很简单,attention的计算涉及到4个矩阵,分别是query矩阵,key矩阵,value矩阵和output矩阵。query矩阵将token的特征转换为查询特征,key矩阵转换为键特征,value转换为值特征。然后self-attention就是用q和k计算相似度,然后按照相似度给v作加权求和,得到一个新的v,再通过output矩阵映射回模型的特征空间。具体的公式是
多头就是假设有h个头,每次attention都在单独的头上计算,他只影响我们切分QKV的时候切出来的每个矩阵维度是多少。每个矩阵的维度都是,实践的时候会拼成一个的矩阵,然后计算过程中可以直接计算,算完后按照head数量和qkv来做划分。
import torch, torch.nn.functional as F

def attention(Q, K, V, mask=None):
    # Q,K,V: (batch, heads, seq_len, d_k)
    d_k = Q.size(-1)
    scores = (Q @ K.transpose(-2, -1)) / d_k ** 0.5   # (b,h,s,s)
    if mask is not None:                               # 因果掩码 -> 不能看未来
        scores = scores.masked_fill(mask == 0, float('-inf'))
    attn = F.softmax(scores, dim=-1)
    return attn @ V, attn

class MultiHeadAttention(torch.nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        assert d_model % n_heads == 0
        self.h, self.d_k = n_heads, d_model // n_heads
        self.qkv = torch.nn.Linear(d_model, d_model * 3)
        self.out = torch.nn.Linear(d_model, d_model)
    def forward(self, x, mask=None):
        b, s, _ = x.shape
        qkv = self.qkv(x).reshape(b, s, 3, self.h, self.d_k).permute(2,0,3,1,4)
        # 维度变成 (3,b,h,s,d), 方便后续拆分和计算
        q, k, v = qkv[0], qkv[1], qkv[2]
        ctx, _ = attention(q, k, v, mask)
        ctx = ctx.transpose(1,2).reshape(b, s, -1)
        return self.out(ctx)
这里有两个容易被忽略的问题。
为什么不直接用token的特征做value? 一是K和V的职责不一样,K决定“我能被谁找到”,V决定“被找到之后我交出什么”,同一个token用来匹配的特征和需要传递出去的信息往往不同。比如“it”去找它指代的名词时,匹配靠的是“名词、单数”这类特征,但真正要带回来的是这个名词的语义。二是多头需要不同的子空间,每个头的是的矩阵,把token投影到不同的子空间,让每个头提取不同的信息;如果直接令V=X,每个头都只能对完整的原始维向量做加权平均,而softmax的权重都且和为1,所以结果只是原始向量的“混合”,挑选不了要传哪些信息。从计算上看,单头时里的其实可以合并成一个矩阵,而多头时每个头的是一个秩为的矩阵,相当于对它做了低秩分解,如果去掉,PV这一步的计算量会变成原来的h倍。当然也不是绝对必需的,Simplifying Transformer Blocks在配合其他改动的情况下就去掉了value和output投影,训练速度也没有损失。
output矩阵的作用是什么? 多个头的结果拼接起来只是首尾相接,头和头之间没有任何交互,负责把各个头的信息融合到一起,写成公式就是,即每个头各自投影回维再相加。同时attention的输出还要和输入做残差连接,负责把结果映射回残差流的特征空间(有的模型,比如Gemma-7B是而,这时维度也要靠变回来)。这个求和的形式也是后面张量并行只需要一次AllReduce的原因。
一个常考的问题是为什么要除以,原因是(q和k分别是Q和K的某一行)的过程中,方差发生了变化,假设q和k都是均值为0,方差为1的随机变量,且相互独立,那么的方差就是
所以除以可以将方差放缩到1,否则分数一旦特别大,softmax 会几乎把全部权重压给某一个位置,进入”饱和区”——此时它对输入的梯度(衡量”参数稍微变一点、损失会变多少”的导数,是模型学习的依据)几乎为 0,模型学不动。除以 √d_k 正好把方差拉回 1 附近,让分数处在 softmax 的灵敏区间,训练更稳。
另一个需要关注的是softmax的计算过程。因为很容易溢出,所以实际计算时会先减去最大值,即,其中,这叫safe softmax。但这样需要先扫一遍求最大值,再扫一遍求指数和,最后再扫一遍做归一化。online softmax把前两遍合成了一遍,边读边更新当前的最大值和指数和。后续FlashAttention的时候,每个矩阵都被切分成了不同的块放在GPU的快速内存SRAM,通过online softmax,我们可以把不同块的结果快速的合并到一起。本质上是因为最大值从变成时,只需要给之前的结果乘上一个系数,就能修正softmax里每一个e项的指数。
多头结构天然适合并行化。8 个头的计算完全独立,可以:
- GPU 内并行:利用 batch 维度,在一次 CUDA kernel 启动中同时处理所有头
- 多卡张量并行(Tensor Parallelism):将不同头分配到不同 GPU 上,每张 GPU 只计算自己负责的若干头。比如 8 个头分到 4 张 GPU,每张处理 2 个头。具体来说,QKV矩阵按列切(即按头切分),output矩阵按行切,每张 GPU 用自己那几个头的结果乘上对应的几行得到一个部分和,最后通过一次 AllReduce 求和就是完整的输出,中间不需要任何通信
多头的方式也有很多种,比如MHA,MQA,GQA,MLA。MHA中每个头都是独立的QKV,MQA中只有一个K和V,被所有Q共享。GQA就是将Q分组,每个组内部只有一个K和V。MLA不直接缓存完整的 K 和 V 向量,而是将它们压缩到一个低维潜在空间(latent space),只缓存这个低维表示。推理时再将低维表示解压回完整的 K 和 V。即原本是,现在是,c的维度非常小,因此对KV Cache的内存占用情况比较友好。
假设长度为N,维度为d,那么一次attention的计算量就是QKVO矩阵的计算量+点积+softmax V的计算量。QKVO每次都是,点积是,softmax V是,所以总共是,所以不管是N还是d主导,都是平方的量级
标准 Attention 依次计算 、 和 ,其中 。两次矩阵乘法的计算量均为 ,Softmax 为 ,因此总计算量为 ;由于需要将 的分数矩阵 和权重矩阵 写入 HBM 再读取,总 HBM 访问量为 。FlashAttention 将计算拆成能放入片上存储的小块,对于每行 query,逐块维护最大分数 、指数和 和加权向量和 ,最终得到 ;当最大值改变时,对已有累计量重新缩放后继续合并。通过在同一个 kernel 中连续完成这些步骤,临时分数和权重无需写入 HBM。因此,FlashAttention 的总计算量仍为 ,但在片上容量为 个元素、 的模型下,总 HBM 访问量为 ;只有当 时,后者才成为 。
在prefill阶段和decode阶段的瓶颈是不一样的,prefill阶段主要是计算瓶颈,需要快速的计算出首个token,这个时候基本都是矩阵乘法。decode阶段主要是把上一个token送到模型里得到Q,然后再通过之前缓存的K和V来不断的计算,得到下一个token,这个时候基本是内存调度。
FFN与激活函数
FFN(Feed-Forward Network)是decoder block里的另一半,结构很简单:先升维,过一个激活函数,再降维回来,即,其中是,是。和attention不同,FFN对每个token单独计算,token之间没有任何交互,可以理解为attention负责在token之间搬运信息,FFN负责加工每个token自己的信息。按前面的计算,一个block里attention是的参数,FFN是,FFN占了大约2/3的参数量。
激活函数是FFN里唯一的非线性部分,如果没有它,两个矩阵直接可以乘成一个矩阵,FFN就退化成了一次线性变换。从最早的ReLU到现在主流的SwiGLU,激活函数大概经历了“硬截断 → 平滑 → 门控”这样的演进。为什么FFN要先升维再降维?核心原因是:激活函数是逐元素作用的,能表达多少种非线性,取决于有多少维可以让它作用。
- 升维是为了给非线性留空间: 的每一列可以看成一个”特征检测器”,判断输入里有没有某种模式;激活函数再决定这个检测器要不要触发。升到 4d,就有 4d 个检测器,能组合出的模式比 d 个多得多。如果一直停在 d 维,ReLU 这类激活还会把一部分维度直接截成 0,信息损失很大,表达力也弱很多。
- 降维是为了回到原来的尺寸:FFN 的输出要和输入做残差相加,block 才能一层层堆起来,所以必须变回 d 维。
- 也可以看成一块”记忆”:有工作(Geva 等人,2021)把 的列看成 4d 个 key, 的行看成对应的 value。输入匹配上哪些 key,就把那些 value 加权加回来。这个结构和 attention 很像,区别是 key 和 value 是训练出来的固定参数,不来自上下文。
- 为什么是 4 倍:这主要是经验值,是效果和计算量之间的折中。正好让 FFN 的参数量是 ,换成 SwiGLU 时,中间维度缩到 也是为了保持这个总量不变。
ReLU
原始Transformer的FFN用的就是ReLU,即,T5和OPT也是ReLU。它的优点是计算非常便宜,只需要一次比较;正半轴的导数恒为1,不会像sigmoid和tanh那样饱和,缓解了梯度消失;而且负输入全部变成0,激活是稀疏的,Deja Vu、PowerInfer这类推理优化就是利用这种稀疏性跳过一部分计算。缺点是存在Dead ReLU问题,一个神经元的输入如果长期落在负半轴,梯度恒为0,可能再也“活”不过来;另外它在0点不可导,负半轴的信息也被一刀切掉了。
GELU
其中是标准正态分布的累积分布函数。直觉上就是给输入x乘上“一个标准正态随机变量小于x的概率”,x越大越接近原样输出,x越负越接近0,相当于一个平滑版的ReLU。BERT、GPT-2/3、ViT用的都是GELU。优点是处处平滑可导,负半轴有小的非零梯度,不存在dead neuron的问题;而且它是非单调的,在处有一个约的最小值,表达力比ReLU稍强。缺点是需要计算erf或者tanh,比ReLU贵;另外它有精确版和tanh近似版两种实现(GPT-2用的是近似版,HuggingFace里叫gelu_new),训练和推理用的版本不一致会带来细微的数值差异;输出也基本不稀疏。
Swish/SiLU
SiLU是Swish在时的特例,也是现在最常用的形式。时趋近ReLU,时退化成线性函数。SiLU和GELU的形状非常接近,同样平滑、非单调(在处有约的最小值),没有dead neuron问题,而且只需要一个sigmoid,比GELU精确版便宜,也很容易和其他算子融合。它可以理解为“自门控”,用x自己的sigmoid决定放行多少。缺点同样是比ReLU贵、输出不稀疏。单独作为激活函数时它相比GELU优势不大,现在最重要的用途是作为SwiGLU里的门控。
SwiGLU
严格来说SwiGLU不是一个激活函数,而是一种FFN结构,来自GLU Variants Improve Transformer。它基于GLU(Gated Linear Unit):
其中是逐元素相乘。放到FFN里就是
其中和都是的矩阵,是的矩阵,即先分两路升维到,逐元素相乘之后再降维回。LLaMA系列、Qwen、Mistral、DeepSeek、PaLM用的都是SwiGLU,Gemma用的是把SiLU换成GELU的GeGLU。这就是前面说的“升维降维和gate矩阵”:比普通FFN多了一个矩阵,为了保持参数量不变,中间维度从缩小到,这样,和不带gate的FFN一样。比如LLaMA-7B的,,再向上取整到256的倍数就是11008。
class SwiGLUFFN(torch.nn.Module):
    def __init__(self, d_model, d_ff):
        super().__init__()
        # gate和up拼成一个矩阵,一次GEMM算完
        self.gate_up = torch.nn.Linear(d_model, d_ff * 2, bias=False)
        self.down = torch.nn.Linear(d_ff, d_model, bias=False)
    def forward(self, x):
        gate, up = self.gate_up(x).chunk(2, dim=-1)
        return self.down(F.silu(gate) * up)
SwiGLU的优点是效果好,在相同参数量和计算量下,困惑度明显低于ReLU和GELU的FFN(原论文对原因的解释只有一句“we attribute their success, as all else, to divine benevolence”)。直觉上门控是一种乘法交互,up分支负责产生内容,gate分支逐元素决定每一维放行多少,比单纯的“线性+激活”表达力更强。缺点主要有:
- 多了一次GEMM,不过gate和up可以像QKV一样拼成一个的矩阵一次算完
- 激活显存更大,反向传播需要保存gate和up两个维的中间结果
- 不是硬件友好的维度,需要手动取整到64、128或256的倍数
- 激活值容易出现很大的离群值(outlier),对FP8/INT8量化不友好,Scaling FP8 training to trillion-token LLMs就专门为此提出了Smooth-SwiGLU
- 输出不稀疏,用不上基于激活稀疏的推理加速,也有工作反过来把模型改回ReLU来换取稀疏性,比如ReLU Strikes Back
| 激活函数 | 公式 | 平滑 | 稀疏性 | 计算开销 | 代表模型 |
|---|---|---|---|---|---|
| ReLU | 否 | 高 | 最低 | 原始Transformer、OPT、T5 | |
| GELU | 是 | 低 | 较高 | BERT、GPT-2/3 | |
| SiLU | 是 | 低 | 中 | 主要作为SwiGLU的门控 | |
| SwiGLU | 是 | 低 | 多一个矩阵 | LLaMA、Qwen、DeepSeek |
IMPORTANT
张量并行时,和按列切,按行切,最后一次AllReduce,和attention里QKV和的切法完全对称。为什么只需要一次通信?列切之后每张卡拿着完整的和一部分列,算出的是gate和up的一部分维度,而激活和逐元素乘法都只作用在自己这部分维度上,不需要别的卡的数据;按行切,每张卡用自己那部分维度乘对应的几行,得到一个完整形状的部分和,最后一次AllReduce相加就是完整输出。要注意gate和up必须切相同的列放在同一张卡上,因为两者之间要逐元素相乘,如果像前面代码那样把gate和up拼成一个矩阵,切分时要先分别切再拼,不能直接把拼好的矩阵对半切。
MoE
MoE(Mixture of Experts,混合专家)改造的正是FFN:与其用一个巨大的FFN,不如把它拆成多个较小的专家(Expert),每个专家都是一个独立的FFN,每个token只激活其中少数几个。比如一个MoE层有64个专家,每个token只选Top-2,那么总参数量是64个专家之和,但每个token的计算量只有2个专家。这样就做到了“参数量大、计算量小”:模型有足够的容量存知识,训练和推理的计算成本却可控。
决定每个token去哪些专家的是路由器(Router/Gate),最常见的是Top-K路由:
其中是的矩阵,把token映射成一个维的概率分布,选出概率最大的K个专家,再把它们的输出按加权求和。这里的会在选中的K个专家里重新归一化,保证输出的尺度和单个FFN一致。
MoE训练中最棘手的问题是负载不均衡:路由器可能把大部分token都发给少数几个“明星专家”,其他专家得不到训练、越来越差,又进一步加剧不均衡,形成恶性循环。常见的缓解办法有三种:
- 辅助损失(Load Balancing Loss):在训练目标里加一项,其中是专家i实际收到的token比例,是路由器分给专家i的平均概率,是平衡系数,负载越均匀这一项越小。来自Top-K的选择,本身不可导,乘上可导的才能把梯度传回路由器
- 容量因子(Capacity Factor):给每个专家设一个最多接收的token数,超出的token被丢弃(直接走残差)或者重新路由到其他专家,从硬约束上防止单个专家过载
- Expert Choice路由:反过来让每个专家主动选自己要处理的top-k个token,天然保证每个专家处理的token数相同,从根本上解决负载不均衡
IMPORTANT
MoE带来了一种新的并行维度——专家并行(Expert Parallelism,EP):每个专家都是独立的FFN,可以把不同专家放在不同的GPU上。它的通信模式和张量并行完全不同,TP用的是AllReduce,而EP用的是All-to-All:每张GPU要把路由到其他卡上专家的token发过去,同时接收路由到本地专家的token,算完之后再通过一次All-to-All发回原来的卡。这种通信对网络拓扑和通信库的要求和AllReduce截然不同,是MoE系统设计的核心挑战,Mixtral 8x7B、DeepSeek-V2这些模型的部署背后都有专门设计的EP调度和通信优化。
Kernel融合
激活函数本身的计算量在FFN里几乎可以忽略,耗时基本都在GEMM上。但GPU上每次kernel启动都有几微秒的调度开销,而且每个独立的kernel都要从HBM读输入、再把输出写回HBM。激活、逐元素乘法这些操作都是memory-bound的,如果每一步都单独一个kernel,的中间结果就要在HBM和SRAM之间来回搬。所以和FlashAttention一样,FFN里也会大量做kernel融合,典型的有四种:
- Swish激活+门控乘法融合:把
silu(gate) * up写成一个kernel(比如vLLM的SiluAndMul),gate的中间结果留在寄存器里直接和up相乘。未融合时要读gate和up、写入再读回Swish的结果、最后写出hidden,一共5次HBM访问;融合后只需要读两个输入、写一个输出,降到3次 - GEMM+激活融合(Epilogue Fusion):在GEMM kernel把结果写回HBM之前的收尾阶段(epilogue),直接在寄存器里对每个输出元素做Swish,省掉一个单独的激活kernel和一次HBM读写,cuBLAS和CUTLASS都提供了epilogue fusion的接口
- 和的GEMM合并:两者的输入都是同一个x,可以沿列拼成一个的大矩阵,一次GEMM算完再切成gate和up,也就是前面代码里的
gate_up。这样少一次kernel launch,而且一个大GEMM的GPU利用率通常比两个小GEMM更高 - 偏置+残差+Norm融合:FFN的输出还要加偏置(如果有)、和残差相加、再进入下一个Norm,把这些逐元素操作融合成一个kernel,一次读入FFN输出、残差和Norm参数,在片上算完再写回,避免多次HBM往返
融合的收益在decode和prefill阶段不一样。decode阶段每次只处理一个token,GEMM退化成矩阵-向量乘,计算量很小,kernel launch和HBM带宽才是瓶颈,融合的收益很明显;prefill阶段GEMM的计算量占主导,逐元素操作的开销占比小,融合的收益就相对有限。这也正好对应了前面说的prefill是计算瓶颈、decode是内存瓶颈。
位置编码
前面的attention根据内容去找内容,但内容相同、位置不同的token,应该怎么区分? 比如“我喜欢你”和“你喜欢我”,词一样,意思却不同。如果没有位置信息,也没有causal mask,交换输入矩阵的几行,attention的输出只会跟着交换对应的几行,这叫排列等变性(Permutation Equivariance):
其中是交换token顺序的置换矩阵。注意这里不是说输出完全不变,而是模型只知道每个token的内容,不知道它在序列里排第几。causal mask通过“谁能看到谁”引入了方向和顺序约束,但它没有直接给出位置编号或距离,因此decoder仍然通常会加入位置编码。
位置编码主要有两条路线:绝对位置给token标上“我是第几个”,通常把位置向量加到embedding上;相对位置让attention知道“你离我有多远”,可以修改Q/K,也可以直接修改attention分数。Sinusoidal和Learned PE属于前者,RoPE和ALiBi则让attention显式利用相对位置关系。
Sinusoidal与Learned PE
原始Transformer采用Sinusoidal编码,用不同频率的正弦和余弦组成一个维的位置向量,再和token embedding相加:
其中是位置,,这里假设为偶数。可以把每对维度理解成一个转速不同的钟:高频的钟转得快,容易区分相邻位置;低频的钟转得慢,能在更长的范围里提供位置信息。把这些钟的读数拼起来,就得到位置的表示。
为什么它也方便模型利用相对位置?固定一个偏移,根据三角函数的和角公式:
也就是说,可以由做一个只依赖的线性变换得到。不过,这只是位置向量本身的性质;加到embedding后,Q/K投影还会把内容和位置混在一起,最终attention分数并不保证只依赖相对位置。也就是说,并不保证模型一定能学习到这种线形关系,而且位置信息也会随着深度而衰减
另一种更直接的做法是Learned PE:训练一个的位置embedding表,输入就是。优点是模型可以自己学习位置表示,实现也只需要查表和相加;代价是增加个参数,超过表长就没有对应的向量,扩展时需要插值、扩表或重新训练。Sinusoidal没有可学习参数,也能算出任意位置的向量,但“公式算得出来”和“模型在没见过的长度上表现好”是两回事,不能据此保证长上下文效果。
RoPE
RoPE(Rotary Position Embedding)换了一个思路:不把位置向量加到输入上,而是在每层attention中,按照位置旋转Q和K。下面用单个头的列向量说明,假设整个头都参与旋转、为偶数。
每相邻两个维度组成一个二维平面,位置对应旋转,不同平面使用不同频率:
是频率基数,原始方案取10000,具体模型要读取自己的配置。K做同样的旋转,V通常不旋转,因为位置在这里影响的是“去哪里找信息”,而V仍然携带要传递的内容。旋转保持向量的长度,改变的是它们之间的方向关系。
把所有二维旋转拼成一个分块对角矩阵,有、,因此:
这就是RoPE的核心:用绝对位置施加旋转,却让内积中的位置因素只依赖相对位置差。 直觉上,把两个箭头一起再转相同的角度,它们之间的夹角不变,所以一起往后挪相同的距离,位置贡献也不变。当然本身还包含内容,不能把它理解成“只要距离一样,attention分数就一样”。各个频率的贡献也会振荡,并不是距离越远分数就必然越低。
工程里不需要构造一个的旋转矩阵,按维度配对做乘加就行:
下面的NumPy代码演示相邻维度配对,输入是一个头的向量:
import numpy as np

def precompute_rope(dim, max_seq_len, base=10000.0):
    assert dim > 0 and dim % 2 == 0
    inv_freq = base ** (-np.arange(0, dim, 2, dtype=np.float32) / dim)
    angles = np.outer(np.arange(max_seq_len, dtype=np.float32), inv_freq)
    return np.cos(angles), np.sin(angles)

def apply_rope(x, cos_cache, sin_cache, positions):
    # positions是每个token的逻辑位置,decode时要接着历史位置往后数
    cos, sin = cos_cache[positions], sin_cache[positions]
    even, odd = x[:, 0::2], x[:, 1::2]
    out = np.empty_like(x)
    out[:, 0::2] = even * cos - odd * sin
    out[:, 1::2] = even * sin + odd * cos
    return out

positions = np.arange(64)
rng = np.random.default_rng(0)
q = rng.standard_normal((64, 128)).astype(np.float32)
k = rng.standard_normal((64, 128)).astype(np.float32)
cos, sin = precompute_rope(dim=128, max_seq_len=4096)
q_rotated = apply_rope(q, cos, sin, positions)  # q: (seq_len, 128)
k_rotated = apply_rope(k, cos, sin, positions)
预计算cos/sin是为了避免每次重复算三角函数,相同频率配置的头和层可以共享表。这里用FP32计算角度和三角函数,实际kernel可以按需要转换存储精度;长位置下尤其要避免直接用BF16表示位置编号,低精度会把不同位置舍入成同一个数。还有些实现把前后半段的维度配成一对,或只旋转头的一部分维度,推理kernel必须和模型训练时的配对方式一致。
ALiBi与方案对比
ALiBi(Attention with Linear Biases)更简单,直接给attention分数加一个和距离成正比的负偏置。对于causal attention,位置只能看的token,第个头的分数是:
不同头使用不同的固定斜率,有的更偏向邻近token,有的保留更远的信息。优点是没有位置embedding参数,也没有查表长度上限,换到更长的序列时仍然能按距离计算偏置;缺点是引入了明确的“越近越优先”倾向,远距离信息会受到更强的惩罚,实际外推效果仍然取决于模型和任务。实现时可以在attention tile内直接生成偏置,不必额外存一个矩阵。
| 方案 | 位置信息加在哪里 | 额外参数 | 推理操作 | 长上下文的主要限制 |
|---|---|---|---|---|
| Sinusoidal | 输入embedding | 无 | 位置查表或计算,再相加 | 无硬性表长限制,但未见长度的效果不保证 |
| Learned PE | 输入embedding | 查表、相加 | 超过表长需要扩展并适配 | |
| RoPE | 每层的Q/K | 无 | 成对旋转,可融合 | 通常需要合适的频率扩展和训练适配 |
| ALiBi | attention分数 | 无 | 按距离加偏置,可融合 | 距离惩罚带来偏向邻近位置的限制 |
RoPE的优势在于把相对位置放进了Q/K内积,又不改变张量形状或增加可学习参数,可以沿用现有的attention和KV Cache框架。但位置编码是模型结构的一部分,不能在部署时随意把Learned PE换成RoPE或ALiBi,训练出来的权重依赖原来的位置表示。
长上下文扩展
RoPE能算出任意位置的旋转,不代表模型能处理任意长度。训练时只见过4K长度,推理直接用到32K,会遇到没学过的位置相位和距离组合。上下文扩展需要在保留原有位置关系和覆盖更长范围之间做取舍,下面设原长度为、目标长度为,。
- 位置插值(Position Interpolation,PI):把位置换成,即所有频率统一变成,让新序列的角度范围回到原训练范围内。比如4K扩到32K,就把位置除以8。实现简单,原论文配合少量长上下文微调验证了效果;代价是相邻token的角度差也缩小了8倍,高频提供的局部分辨能力被一起压缩
- NTK-aware Scaling:通过增大base,对高低频做不同程度的缩放。一种常见形式是,于是()。最高频不变,最低频缩到原来的,其余频率逐渐过渡,直觉是保留相邻位置的细节,把覆盖长距离的部分拉长。这改善了统一插值损失高频信息的问题,但并不意味着所有模型和微调场景都优于PI
- YaRN:按频段处理,高频基本不缩放、低频做插值、中间平滑过渡,再对attention分数做温度修正。可以理解成“局部关系尽量保持,长距离部分展开,同时校正attention权重的尺度”。YaRN论文系统讨论了NTK-aware、分段插值和动态缩放的取舍
- 动态NTK:按实际序列长度调整频率,短请求使用原配置,长请求再扩展。但如果生成过程中改变了频率,之前缓存的K也必须按同一套频率处理;不能旧K用旧base、新Q用新base。实现需要固定一次请求使用的配置,或者支持对缓存重新旋转等一致性处理
这些方案提供的是扩展位置表示的办法,长文本上的检索、推理和短文本性能还需要实际评估,很多场景也需要长上下文微调。具体的base、缩放方法、原始训练长度和温度系数应当按checkpoint配置读取,Transformers的RoPE文档列出了对应选项。
对Infra的影响
RoPE计算不重,数据搬运和kernel启动却有成本。 旋转只是的乘加,不需要GEMM;如果单独启动kernel,Q/K要多一次HBM读写。可以把旋转和QKV投影后的处理、KV Cache写入或attention前端融合,数据在寄存器或片上存储里转完就接着使用。FlashAttention的KV Cache接口就支持在同一个kernel里完成新K的旋转、缓存更新和attention。decode处理的token少,减少kernel启动尤其有意义,但具体收益要看batch和实际实现。
位置是逻辑编号,不是KV Cache的物理地址。 常规RoPE推理会把旋转后的K写入缓存,后续直接读取,不需要每步重新旋转所有历史K。PagedAttention可以把KV分散存到不同物理页里,但位置仍要按token在请求中的顺序计算;chunked prefill和decode也必须接着之前的位置编号。prefix cache复用时,要保证逻辑位置、模型和RoPE配置一致,动态缩放还要检查实际使用的频率和缩放状态。
能处理更长上下文,还要有显存放得下它。 对普通MHA/GQA,忽略分页元数据,假设每层的头配置相同、batch里的请求都是个token,KV Cache的显存近似为:
其中2对应K和V,是层数,是KV头数,是每个缓存元素占用的字节数。比如32层、32个KV头、头维度128、FP16缓存(每元素2字节)的MHA模型:
| 上下文长度 | 单请求KV Cache | 16个同样长度的请求 |
|---|---|---|
| 4096 | 2 GiB | 32 GiB |
| 32768 | 16 GiB | 256 GiB |
| 131072 | 64 GiB | 1024 GiB |
这还没算模型权重、临时激活和其他运行开销。长度扩展32倍,KV Cache也扩展32倍,并发能力会直接受到影响。GQA/MQA通过减少节省缓存,KV量化减少每个元素的字节数,分页管理降低预留和碎片浪费;滑动窗口或缓存淘汰还能限制保存的token数,但会改变能访问的上下文。FlashAttention避免存储完整的注意力矩阵,并不会消除KV Cache,也不会把完整prefill的attention计算量从变成;decode每生成一个token,读取历史KV的开销仍然随上下文长度增长。
归一化
Norm要处理的是激活值的尺度:同一层的输入如果忽大忽小,后面的attention分数、激活函数和参数更新都更难控制。它通过输入自身的统计量调整尺度,再用可学习参数保留表达能力。这里不要求激活“服从标准正态分布”,归一化也不会凭空让它变成正态分布。
BatchNorm、LayerNorm与RMSNorm
三者的主要区别是沿哪个维度统计,以及要不要减均值。设输入形状为,分别是batch、token数和hidden维度。
BatchNorm沿样本维度对同一个特征统计。先用的输入说明,第个特征的计算是:
处理序列时,有些实现还会把token维度纳入统计。这样一个token的结果依赖其他样本或位置,padding会污染统计,自回归训练还需要防止统计量泄漏未来信息;micro batch很小时,统计也不稳定。常见BatchNorm在训练时用当前batch的统计量,推理时用running mean/variance,又引入了训练和推理的差异。不是说batch=1就无法做推理,running statistics仍然可用,而是这套跨样本统计不适合Transformer逐token、变长序列的计算方式。
LayerNorm反过来,对每个token自己的个特征独立统计。固定后,把这个token的向量记作,有:
这里用的是除以的总体方差,不是统计学里除以的无偏估计。防止分母为0,都是维的可学习参数,通常初始化为1和0。直觉上是把每个token的特征先“减去整体偏移、调整整体幅度”,再让模型自己学哪些维度应该放大、缩小或偏移。
优点是完全不依赖其他token和batch:不同序列长度、padding和逐token生成都不会改变一个token的统计范围,训练与推理采用同样的计算。代价是每次都需要沿hidden维度求均值和方差,这是GPU上的reduction。具体定义可以看Layer Normalization原论文。
RMSNorm进一步简化,不减均值,只按均方根调整幅度,常见实现也去掉了:
和LayerNorm相比,它省掉了均值的统计、中心化以及偏移参数,只保留一个平方和reduction和缩放,参数量从常见LayerNorm的减到。忽略时,输入乘一个正的常数,归一化结果不变;但输入整体加一个常数,结果会变,说明它保留了尺度不变性,放弃了LayerNorm的平移不变性。RMSNorm论文的实验说明,很多任务中保留尺度控制就能取得接近LayerNorm的效果,不必为减均值付出全部成本;这并不是两者对任意输入都等价。
为什么输入均值接近0时两者会很像?因为,当时,两个分母接近,减均值带来的差异也小;若和相同、LayerNorm的,均值恰好为0时输出相同。反过来,时,LayerNorm把它变成大约,RMSNorm则是,整体偏移还在。
下面的NumPy实现展示每个token内的统计,输入可以是;真正训练时,需要作为可学习参数:
def layer_norm(x, gamma, beta, eps=1e-5):
    xf = x.astype(np.float32)
    mean = xf.mean(axis=-1, keepdims=True)
    var = ((xf - mean) ** 2).mean(axis=-1, keepdims=True)
    y = (xf - mean) / np.sqrt(var + eps) * gamma + beta
    return y.astype(x.dtype)

def rms_norm(x, gamma, eps=1e-5):
    xf = x.astype(np.float32)
    mean_square = (xf ** 2).mean(axis=-1, keepdims=True)
    y = xf / np.sqrt(mean_square + eps) * gamma
    return y.astype(x.dtype)
| 方法 | 统计范围 | 是否减均值 | 常见可学习参数 | 主要取舍 |
|---|---|---|---|---|
| BatchNorm | 同一特征上的多个样本,可能包含token维度 | 是 | 跨样本统计,通常依赖running statistics做推理 | |
| LayerNorm | 每个token内部的个特征 | 是 | 不依赖batch,控制偏移和尺度,统计更复杂 | |
| RMSNorm | 每个token内部的个特征 | 否 | 更简单,控制尺度但不消除整体偏移 |
Pre-Norm与Post-Norm
两者用的Norm可以相同,区别在于Norm在残差分支里面,还是残差相加之后。用代表attention或FFN子层:
| 架构 | 主分支数据流 | 残差从哪里接入 | 公式 |
|---|---|---|---|
| Post-Norm | 直接送到Add,结果再过Norm | ||
| Pre-Norm | 直接送到Add,作为输出 |
对应的导数是:
Post-Norm连残差路径也要经过Norm,每往前回传一层都要受到的影响;Pre-Norm把Norm留在计算分支,残差路径仍然有一个不经过Norm的。所以Pre-Norm通常更容易稳定训练深层网络,对学习率和初始化的选择也更宽容。
Xiong等人的分析具体指出,Post-Norm在初始化时,靠近输出层的参数梯度较大,直接用大学习率容易不稳定,warmup可以缓解;Pre-Norm的初始化梯度更好控制,论文在一些任务中甚至去掉了warmup。这里不能进一步推出“Pre-Norm永远不需要warmup”,实际大模型还受优化器、初始化、残差尺度和数值精度影响。
取舍上,Post-Norm每次都把残差相加后的结果归一化,但深层训练往往更依赖仔细的参数配置;Pre-Norm优先让残差路径和子层输入更容易控制,不过残差流本身仍然可能随层数增长,也没有保证每一层都被充分利用。它们的最终效果要结合规模和训练设置比较。
落到前面的decoder block里,一个常见的Pre-Norm结构就是:
很多模型在所有block之后、LM head之前还有一个Final Norm,控制送进输出投影的表示尺度,因为最后一次残差相加后并没有经过下一个block的Norm。原始Transformer使用Post-Norm + LayerNorm;LLaMA使用Pre-Norm + RMSNorm,并保留末尾的Norm,是后者的一个代表。
还有DeepNorm这样的方案,保留类似Post-Norm的,同时按深度设置残差系数和相应的权重初始化。它通过成套的设计改善深层训练稳定性,论文训练到了1000层;不能只给残差随手乘个常数,就认为获得了同样的效果。
对Infra的影响
Norm是reduction,瓶颈常在带宽和调度。 LayerNorm要对一个token的个特征统计均值和方差,再把统计结果用于所有维度,不像GEMM那样有大量可复用的矩阵计算。朴素实现会多次扫描输入;如果一行能留在寄存器或shared memory里,就可以在一个kernel里完成统计和归一化,减少HBM往返。hidden维度更大时,还要权衡线程数、寄存器压力和并行度,并不是融合越多就一定越快。RMSNorm只需要平方和,reduction更简单,但整个模型的提速不能按“少一个统计量”直接推成两倍。
Residual Add + Norm融合。 Pre-Norm中,上一个子层的残差加法和下一个子层的Norm是相邻的,可以先读入和子层输出,在片上得到,马上计算。分开时要先把写回,再由Norm读入;融合省掉中间那次重复读取和一个kernel启动。不过还要沿残差路径继续传下去,常见融合kernel仍然需要同时输出和,不能把未归一化的残差丢掉。训练时还可以在支持的实现中融合bias、dropout等操作。
统计量用FP32,不能只把输入输出设成半精度就结束。 FP16中,数值一平方或多项累加就可能溢出;BF16的动态范围更大,但尾数更短,仍然需要注意求和精度。通常先把输入转成FP32,再做平方、累加、方差和倒数平方根,完成归一化后才把输出转回FP16/BF16。Triton的LayerNorm教程展示了这种实现方式。前面的NumPy示例也是先转换再平方,若先用FP16平方、之后才转FP32,已经溢出的值就救不回来了。
方差还有一个额外问题:虽然数学上正确,但均值很大、方差很小时,两项相近的数相减会损失有效精度。可以像上面的代码一样先减均值再算平方,也可以用能合并分块统计的Welford算法,在线维护样本数、均值和离均差平方和。FP32能缓解误差,但不会自动消除抵消问题;、累加精度和输出转换位置也都要和模型的数值约定一致。
IMPORTANT
Norm的并行方式取决于统计维度有没有被切开。前面常见的张量并行在Norm处保留完整的hidden向量,每张卡可以独立计算;按token切分时,每张卡也仍能处理自己完整的token。若把同一个token的hidden维度分散到不同卡上,LayerNorm的均值和方差、或RMSNorm的平方和就需要跨卡聚合,本来很轻的算子也会引入通信。不能只看到Norm参数量很小,就认为它的并行代价一定很小。